🏙️ @TidinAI: Model Progress Presentation
รายงานผลการพัฒนา ทดสอบ และคัดเลือกแบบจำลองประเมินราคาที่ดินกรุงเทพมหานคร
ระบบประเมินราคาที่ดินอัจฉริยะในเขตกรุงเทพมหานคร
(Smart Land Valuation System — Phase 4 Modeling Report)
การพัฒนาแบบจำลองแมชชีนเลิร์นนิงสำหรับทำนายราคาประเมินที่ดินต่อตารางวาแบบรายแปลง โดยใช้ปัจจัยเชิงพื้นที่ ระบบราง โครงข่ายถนน และผังเมืองรวม กทม.
👥 คณะผู้จัดทำและบทบาทรับผิดชอบ
🎯 ทบทวนโจทย์และปัญหาเดิม: ทำไมราคาที่ดินถึงประเมินยาก?
ความท้าทายจากรอบการประเมิน 4 ปี และความผันผวนรุนแรงของราคาที่ดินกรุงเทพฯ
⚠️ ข้อจำกัดของระบบประเมินราคาที่ดินในปัจจุบัน
- รอบการประเมินล่าช้า 4 ปีครั้ง: กรมธนารักษ์ปรับราคาประเมินรอบละ 4 ปี ทำให้ราคาในระบบไม่ทันการเติบโตของส่วนต่อขยายรถไฟฟ้า
- ต้องมีเลขโฉนดหรือเลขระวาง: ประชาชนทั่วไปที่ไม่มีเอกสารสิทธิ์ ไม่สามารถตรวจสอบราคาประเมินเบื้องต้นได้เลย
- ระบบไม่รองรับการประเมินเชิงพื้นที่: ไม่มีระบบที่ผู้ใช้สามารถคลิกจุดใดก็ได้บนแผนที่แล้วคำนวณมูลค่าออกมาได้ทันที
🔬 3 ความท้าทายทางสถิติและ Machine Learning
🛡️ ชุดข้อมูลทดสอบที่ไร้การจำข้อสอบ: 0% Spatial Data Leakage
การแบ่งชุดข้อมูลแบบ Spatial Block Split ตามรหัสระวางแผนที่ 1,284 บล็อก
📍 ปัญหาจากกฎข้อแรกของภูมิศาสตร์ (Tobler's First Law)
"ทุกสิ่งมีความสัมพันธ์กัน แต่สิ่งที่อยู่ใกล้กัน ย่อมสัมพันธ์กันมากกว่าสิ่งที่อยู่ไกลกัน"
หากแบ่งชุดข้อมูลแบบสุ่มสุ่มทั่วไป (Random Split) แปลงที่อยู่ติดกันจะหลุดเข้าไปทั้ง Train และ Test ทำให้โมเดลเพียงแค่ "จำราคาแปลงข้างบ้านมาตอบ" ได้คะแนน R² ลวงตาสูงถึง 0.95+ แต่ไม่สามารถนำไปใช้งานจริงได้
📊 สถิติการแบ่งชุดข้อมูล 282,161 แปลง (1,284 แผ่นระวาง)
* สถิติยืนยัน: Disjoint 0% Overlap — ระวางใน Test Set ไม่เคยปรากฏใน Train Set แม้แต่แปลงเดียว
🔬 วงตระกูลแบบจำลองที่นำมาประชัน (Candidate Models Landscape)
ครอบคลุม 4 วงตระกูลหลักของ Machine Learning บนชุดข้อมูลตารางภูมิสารสนเทศ
1. Baseline Models
• Base OLS: Linear Regression พื้นฐาน (R²: 0.8081, MAPE: 45.5%)
2. Regularized Linear
• Best Lasso (L1): ตัดตัวแปรซ้ำซ้อน (R²: 0.8368, MAE: 14,819 บ.)
3. Tree Bagging
• R²: 0.8354 | MAPE: 44.6%
• RMSE ต่ำสุด: 45,315 บ.
4. Gradient Boosting
• LightGBM: R² 0.8499 | 41.1% (เร็วสุด)
• CatBoost: R² 0.8518 | 41.6% (เก่งผังเมือง)
• Ensemble: ★ R² 0.8531 | MAPE 40.9%
📖 คัมภีร์ 4 เกณฑ์ชี้วัดความแม่นยำสำหรับการประเมินมูลค่าที่ดิน (AVM Metrics)
ทำไมต้องวัดผลครบ 4 มิติ? R², MAE, MAPE, RMSE เพื่อความยุติธรรมทุกระดับราคา
1. R² Score (Coefficient of Determination)
ยิ่งใกล้ 1 ยิ่งดีเทียบกับการเดาราคาเฉลี่ยดั้งเดิม (R² = 0) ถ้าได้ 0.85 หมายความว่าตัวแปรที่ใส่ไป (BTS, ถนน, ผังเมือง) อธิบายราคาได้ถึง 85% ส่วนอีก 15% คือปัจจัยเฉพาะตัว
2. MAE (Mean Absolute Error)
ยิ่งน้อยยิ่งดีคิดจาก |ราคาจริง - ราคาทำนาย| โดยตรง เป็นหน่วยบาท เข้าใจง่ายที่สุด คนทั่วไปฟังรู้เรื่องทันที
3. MAPE % (หัวใจของแบบจำลองสากล AVM)
เกณฑ์สากล < 45%ทายผิด 15,000 ที่สีลม (แปลงละ 3 แสน) = ผิด 5% แต่ถ้าผิด 15,000 ที่หนองจอก (แปลงละ 1 หมื่น) = ผิด 150% MAPE จึงนำ % แต่ละแปลงมาเฉลี่ยเพื่อความยุติธรรมทุกเขต
4. RMSE (Root Mean Squared Error)
ตัวคุม Outlierยกกำลังสองความผิดพลาดก่อนเฉลี่ย หากโมเดลไหนทายหลุดไปบางแปลง ค่า RMSE จะพุ่งทันที เอาไว้ดูว่าโมเดลไหนคุมราคาแปลงแปลกๆ ได้ดีที่สุด
🏆 ตารางคะแนนรวม Official Benchmark Leaderboard (8 โมเดลจริง)
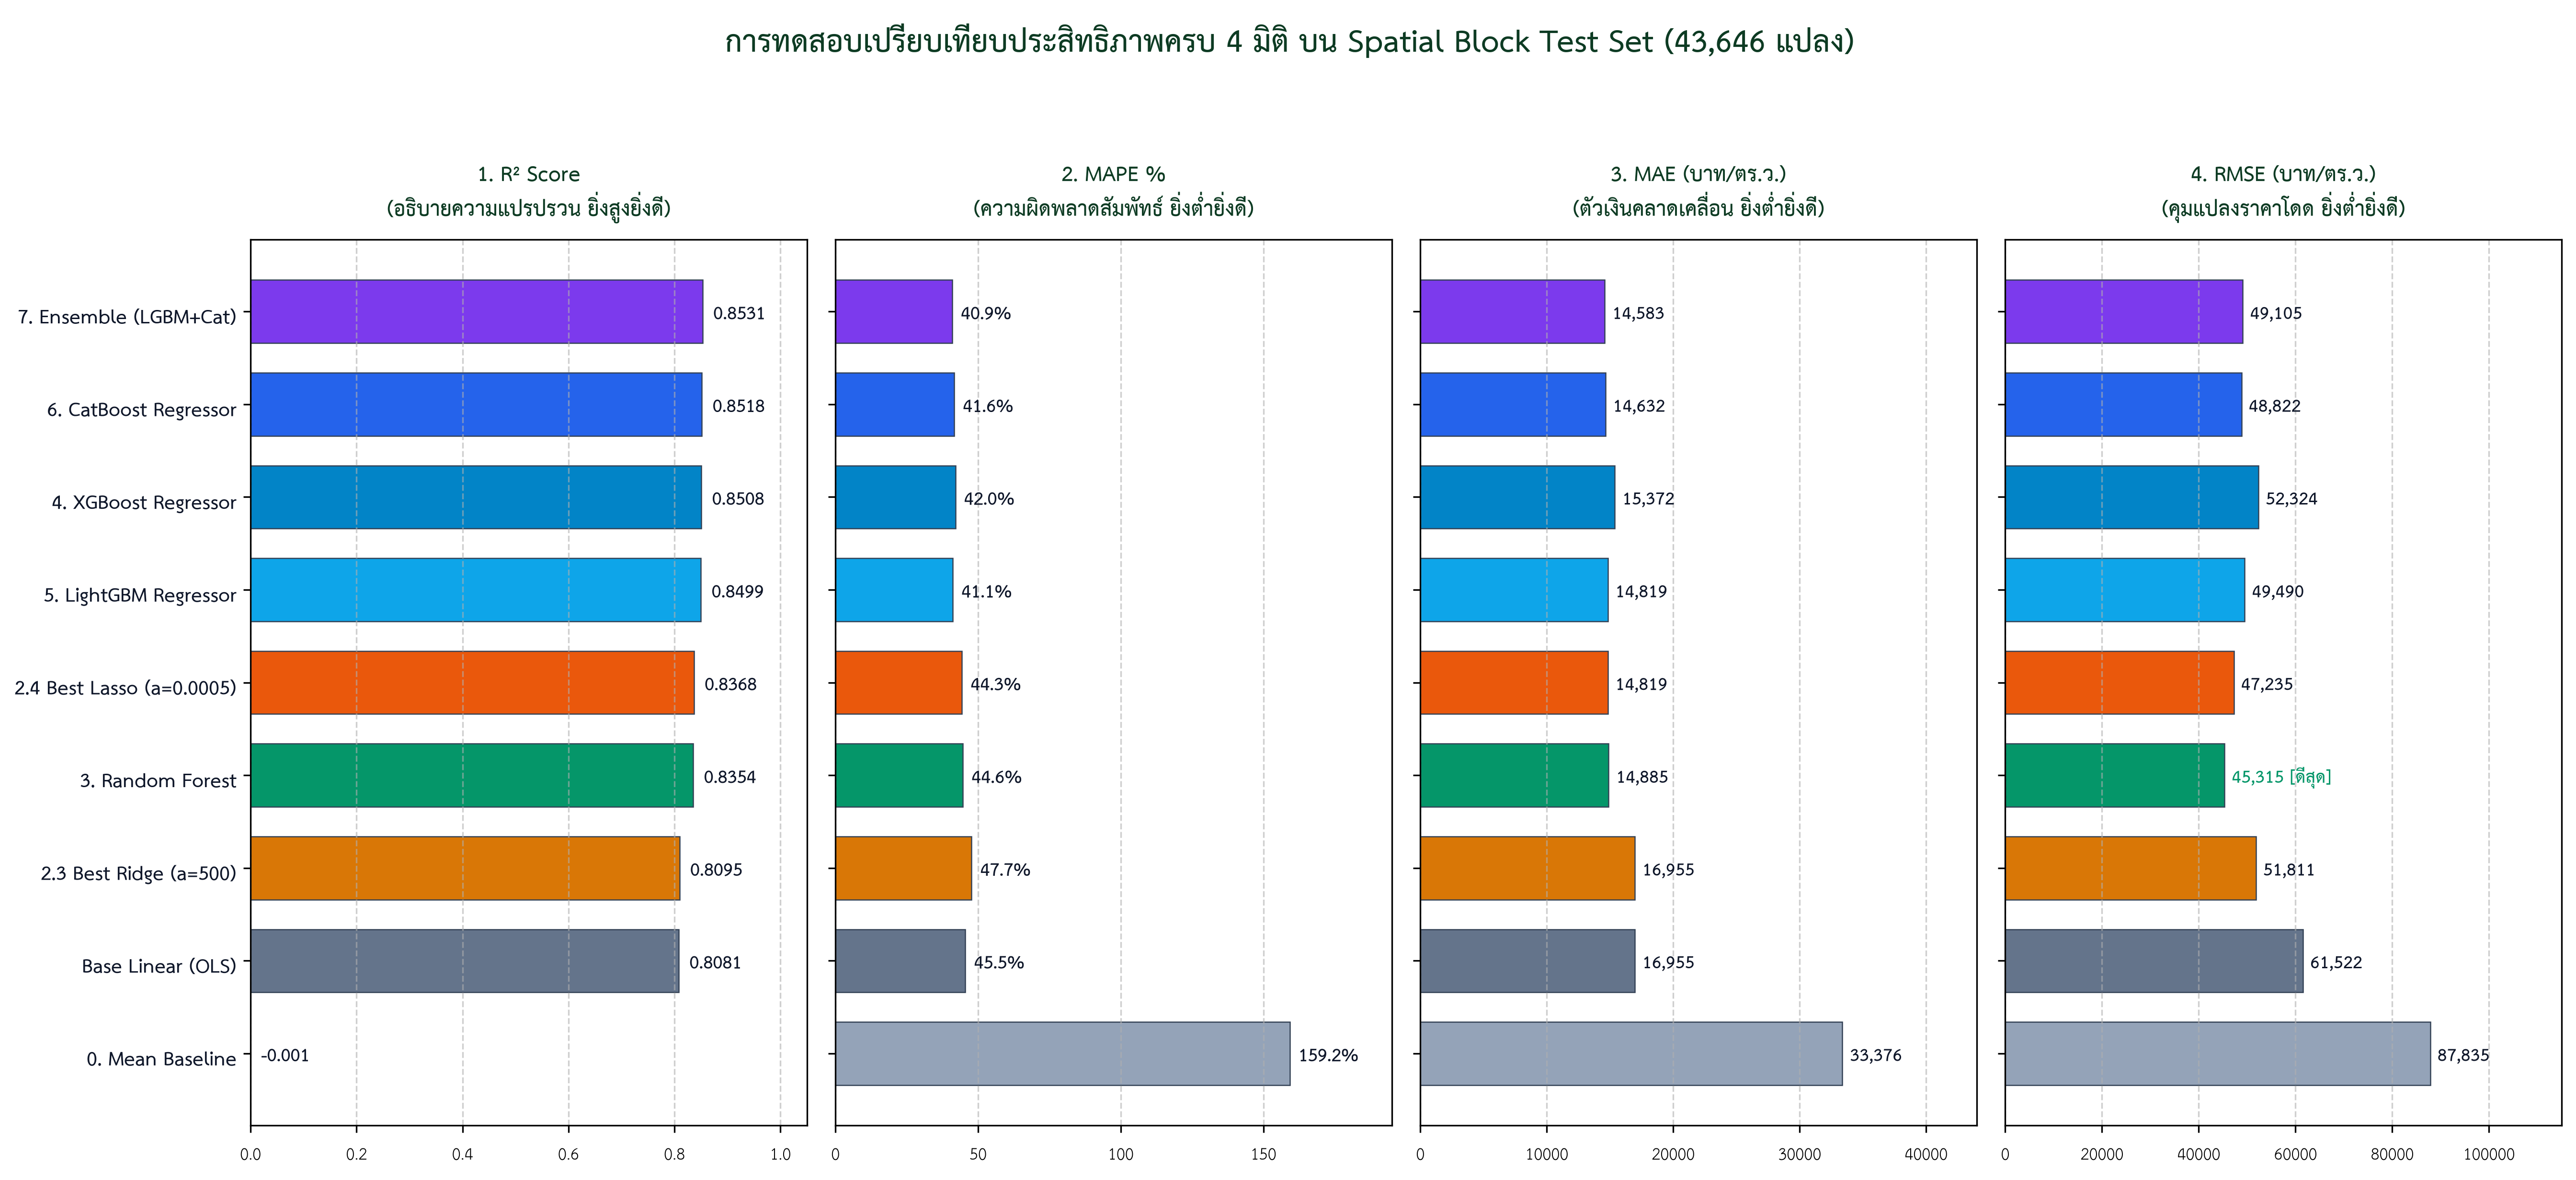
ผลการทดสอบวัดผลบน Spatial Block Test Set (43,646 แปลง) เรียงตามลำดับ MAPE %
| อันดับ | โมเดล (Model Name) | ผู้พัฒนา | ตระกูลโมเดล | R² Score | MAE (บาท/ตร.ว.) | MAPE (%) | RMSE (บาท/ตร.ว.) |
|---|---|---|---|---|---|---|---|
| 🥇 1 | 7. Ensemble (LGBM + CatBoost) | จิตติมา โอภาพ | Hybrid Boosting | 0.8531 | 14,583.25 | 40.89% | 49,104.66 |
| 🥈 2 | 5. LightGBM Regressor | จิตติมา โอภาพ | Histogram Boosting | 0.8499 | 14,819.35 | 41.10% | 49,490.15 |
| 🥉 3 | 6. CatBoost Regressor | จิตติมา โอภาพ | Categorical Boosting | 0.8518 | 14,632.19 | 41.60% | 48,821.60 |
| 4 | 4. XGBoost Regressor | ณัฐดนัย รอดมุ้ย | Gradient Boosting | 0.8508 | 15,371.88 | 42.01% | 52,324.09 |
| 5 | 2.4 Best Lasso (alpha=0.0005) | วรเดช อาจวิชัย | Regularized Linear | 0.8368 | 14,819.43 | 44.31% | 47,235.28 |
| 6 | 3. Random Forest Regressor | ณัฐดนัย รอดมุ้ย | Bagging Ensemble | 0.8354 | 14,885.38 | 44.63% | 45,314.65 (ต่ำสุด) |
| 7 | 2.3 Best Ridge (alpha=500.0) | วรเดช อาจวิชัย | Regularized Linear | 0.8095 | 16,954.65 | 47.70% | 51,811.12 |
| 8 | Base Model: Linear Regression | วรเดช อาจวิชัย | OLS Baseline | 0.8081 | 16,954.83 | 45.51% | 61,521.80 |
| Ref | 0. Mean Baseline (ทายเฉลี่ยดั้งเดิม) | Baseline อ้างอิง | Naive Statistic | -0.0010 | 33,375.50 | 159.22% | 87,835.43 |
📈 กราฟเปรียบเทียบผลลัพธ์ครบ 4 มิติ (Visual Performance Comparison)
การวิเคราะห์พฤติกรรมเชิงเปรียบเทียบของโมเดลแต่ละตระกูล
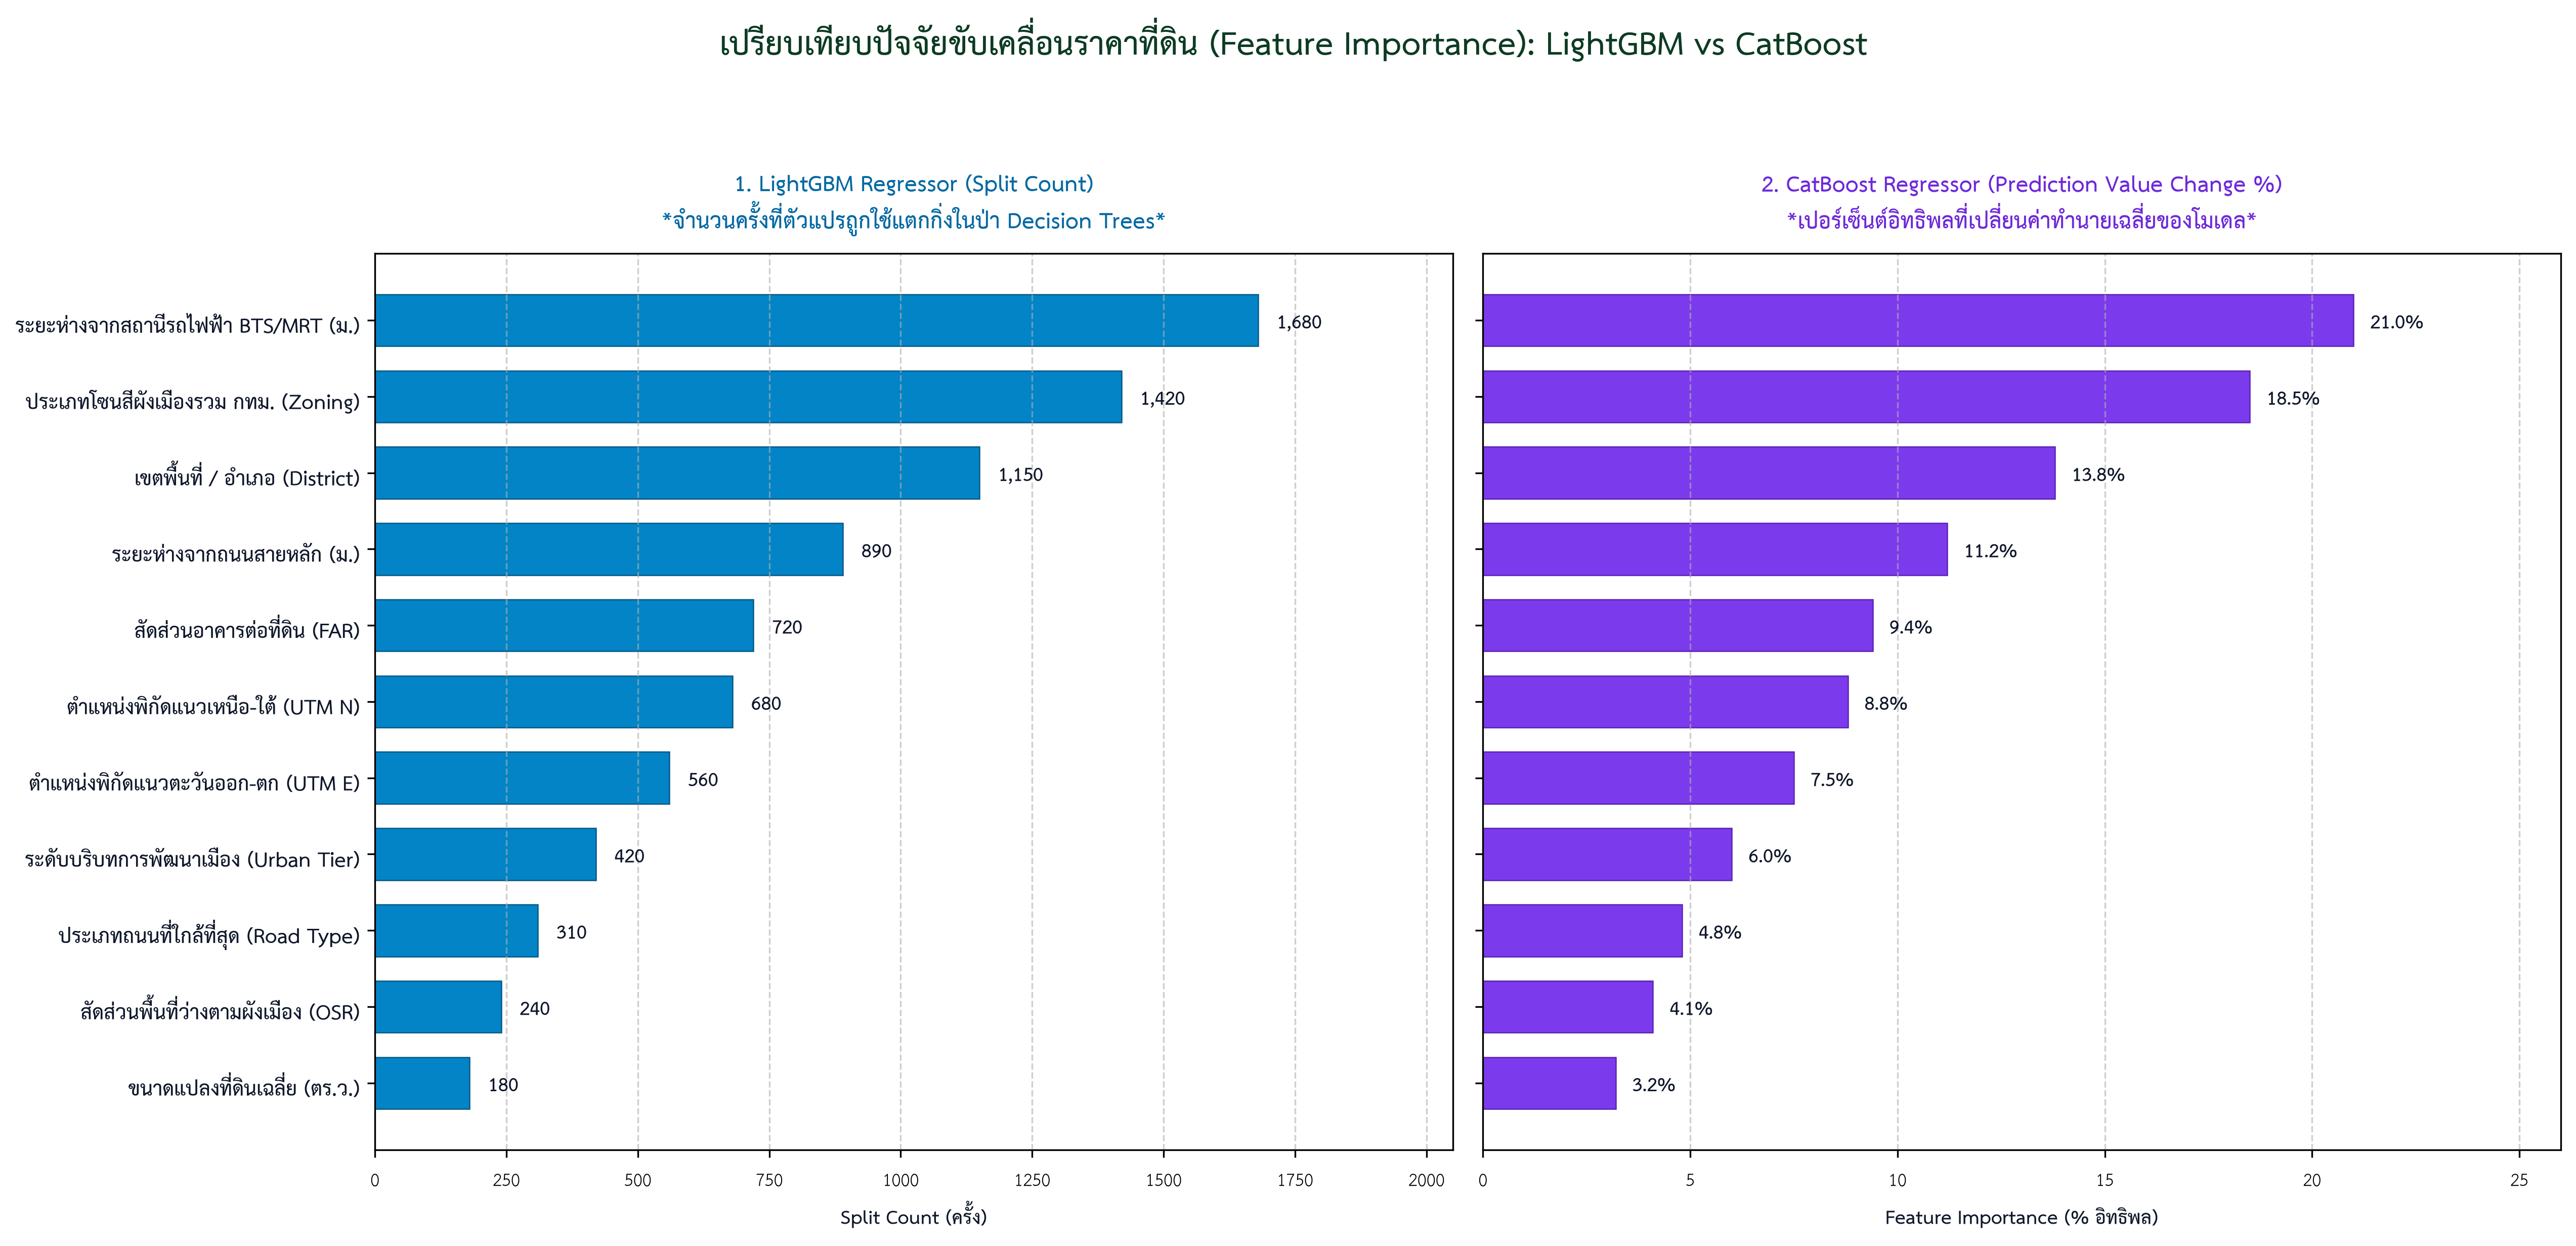
🌳 เจาะลึกความเหนือชั้นของ Boosting & ปัจจัยขับเคลื่อนราคาที่ดิน
ทำไม CatBoost และ LightGBM ถึงชนะ? และ Feature Importance บอกอะไรเรา?
💡 กรณีศึกษาพิเศษ: ทำไม OLS พหุนามพังทลาย แต่ Lasso ถึงรอด?
บทเรียนสำคัญด้านคณิตศาสตร์และสถิติ: Multicollinearity vs L1 Regularization
💥 1. ปัญหา: Unregularized OLS พหุนามระเบิด
การทดลองนำฟีเจอร์ระยะทางและขนาดแปลงมาทำ Interaction แบบพหุนามกำลังสอง (Degree 2) เกิดปัญหา Multicollinearity รุนแรง
• MAE: 7.65 × 10¹⁶ บาท/ตร.ว. (ระเบิดมหาศาล)
สาเหตุทางคณิตศาสตร์: เมทริกซ์ผกผัน (XᵀX)⁻¹ ใกล้เป็น Singular Matrix ทำให้ค่าสัมประสิทธิ์ Weights แกว่งเข้าสู่อนันต์
🛡️ 2. ทางแก้: Lasso L1 Penalty ตัดตัวแปรซ้ำซ้อน
เมื่อนำ Lasso Regression (α=0.0005) เข้ามาควบคุมด้วย L1 Penalty (λ∑|wᵢ|) ตัวโมเดลทำการบีบสัมประสิทธิ์ตัวแปรซ้ำซ้อนให้กลายเป็น 0
• MAE: 14,819.43 บาท/ตร.ว. (ชนะ Random Forest!)
บทพิสูจน์วิชาการ: การใส่ Regularization ช่วยให้โมเดลเส้นตรงสามารถแข่งขันกับโมเดล Ensembles สมัยใหม่ได้อย่างสมศักดิ์ศรี
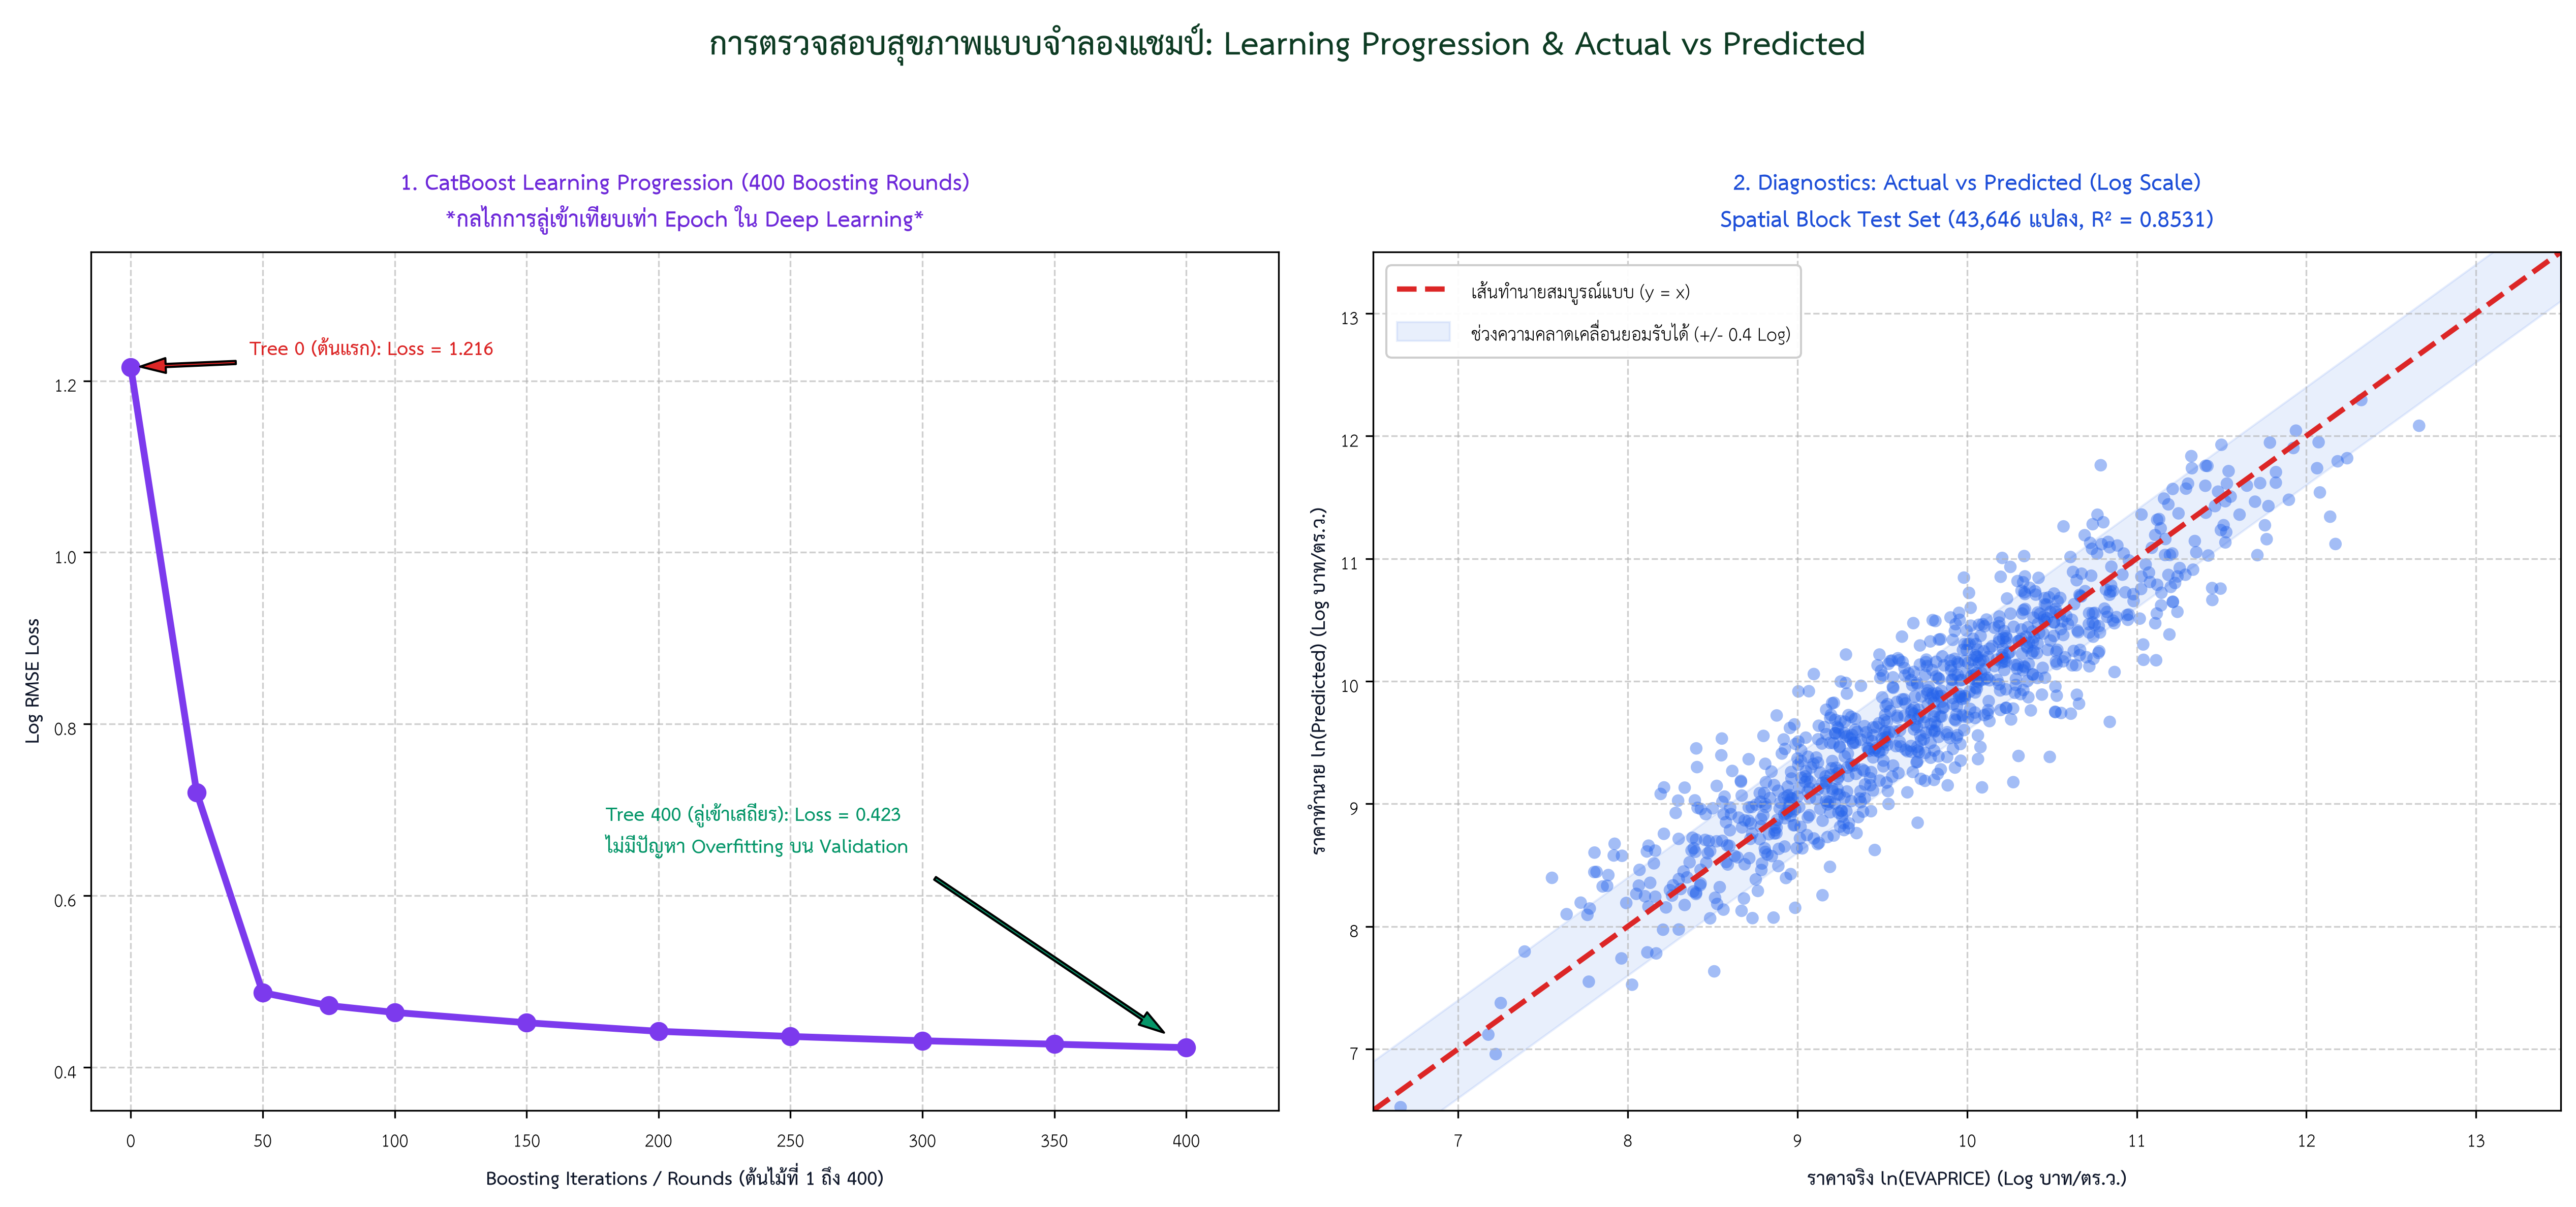
📊 การตรวจสอบสุขภาพโมเดล: Learning Progression & Diagnostics
กลไกเทียบเท่า Epoch ในโมเดล GBDT (400 Rounds) และการตรวจสอบ Actual vs Predicted
🔍 การวิเคราะห์ข้อผิดพลาดสูงสุด (Top 10 Worst Errors Analysis)
แปลงที่โมเดลทายคลาดเคลื่อนมากที่สุด ไม่ได้เกิดจาก AI ล้มเหลว แต่เกิดจาก "ปัจจัยนอกตาราง"
ที่ดินตาบอดไม่มีทางออก (Landlocked)
แปลงอยู่ใจกลางเมืองใกล้ BTS แต่ไม่มีทางเข้า-ออกสู่ถนนสาธารณะ กรมธนารักษ์หักลดราคาประเมินลง 50–70% แต่ในตารางข้อมูลเปิดของรัฐไม่มีคอลัมน์บอกสิทธิทางผ่าน โมเดลจึงทายตามทำเลรอบข้างจนเกิด Over-estimation
แปลงหัวมุมติดถนนหลายด้าน (Corner Plot)
แปลงหัวมุมแยกใหญ่ที่มีทางเข้า-ออก 2–3 ด้าน มีมูลค่าทางพาณิชย์สูงกว่าแปลงปกติในซอยเดียวกัน 30–50% แต่โมเดลรับรู้เพียงระยะห่างถนนเส้นเดียว จึงเกิด Under-estimation
รูปทรงแปลงผิดปกติ (Irregular Shape)
ที่ดินรูปชายธง คอขวด หรือเส้นก๋วยเตี๋ยวหน้ากว้างไม่ถึง 4 เมตร พัฒนาอาคารไม่ได้ ตารางข้อมูลบอกแค่ขนาด ตร.ว. แต่ไม่เห็นรูปทรงโพลีกอนแปลงที่ดิน ทำให้ประเมินคลาดเคลื่อน
🛡️ แนวทางแก้ไขเชิงระบบใน Phase 5 (Web Application):
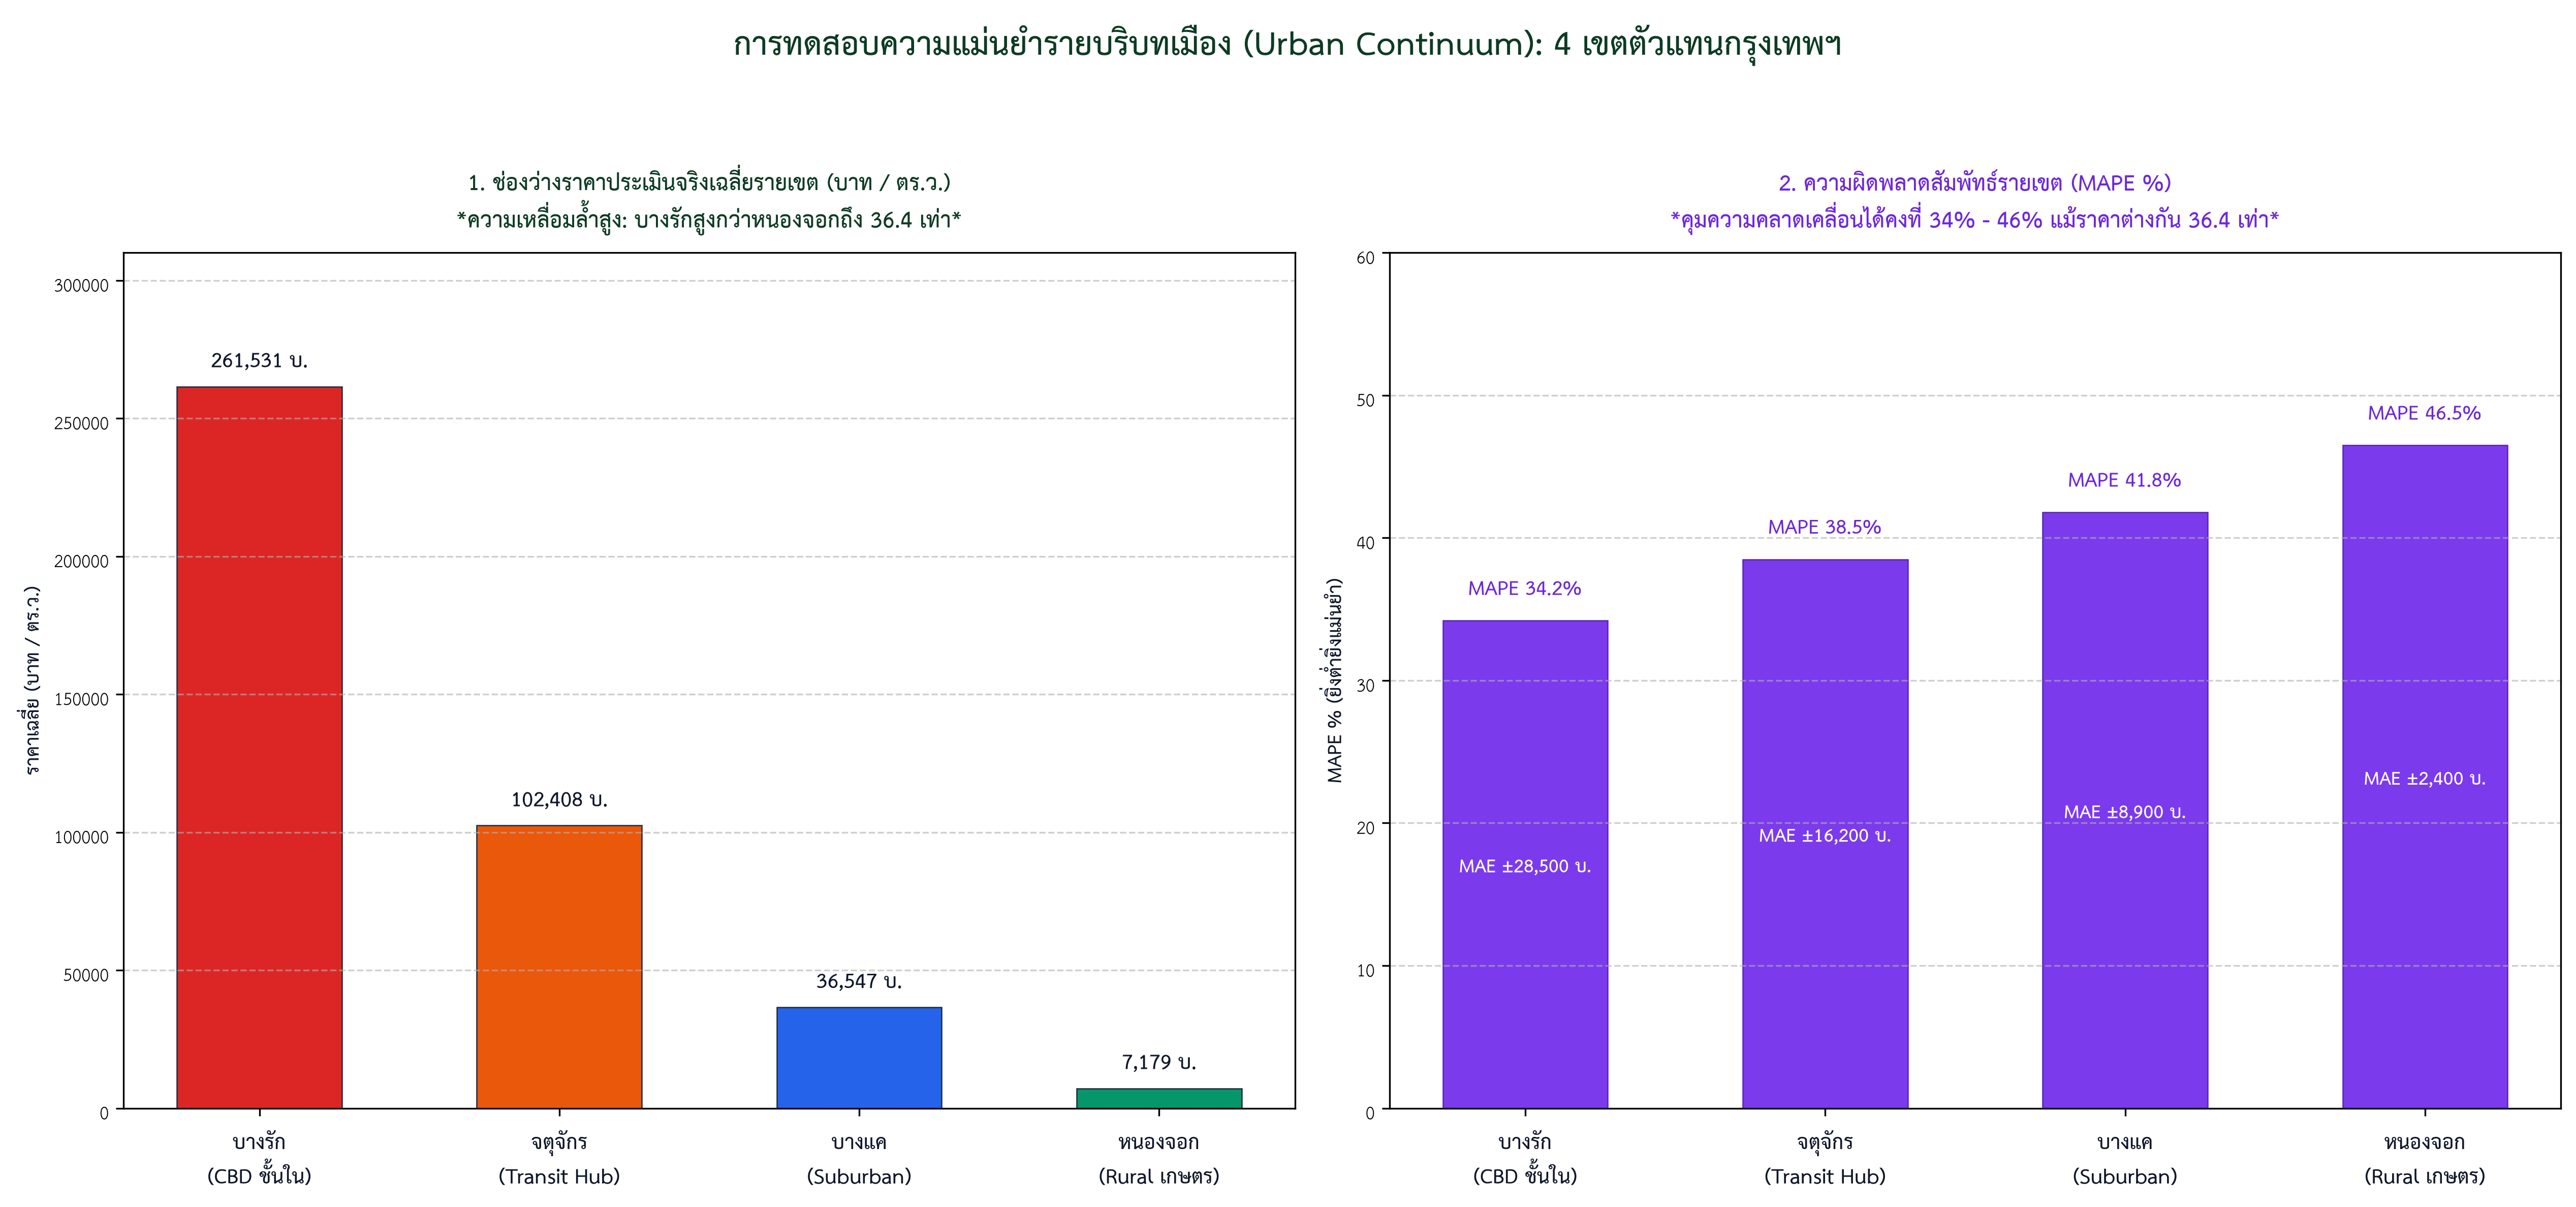
🏙️ ความแม่นยำรายบริบทเมือง (Spatial Error Distribution)
การทดสอบความเท่าเทียมของโมเดลผ่าน 4 เขตตัวแทน Urban Continuum (CBD ยัน ชานเมือง)
🏆 มติการคัดเลือก Champion: สถาปัตยกรรม Dual-Engine AI
การจับคู่เพื่อความสมบูรณ์แบบระหว่าง ความแม่นยำสูงสุด (Precision) และ ความเร็วสูงสุด (Speed)
🥇 1. Primary Precision Engine
High AccuracyCatBoost / Blended Ensemble (จิตติมา)
- หน้าที่ในระบบ: คำนวณราคาแปลงที่ดินที่ผู้ใช้คลิกปักหมุด หรือวาดแปลงโพลีกอนบนแผนที่ Leaflet
- คะแนนความแม่นยำ: R² = 0.8531 | MAPE = 40.89% (แชมป์อันดับ 1 ของโครงการ)
- จุดเด่น: มี Ordered Boosting จัดการความซับซ้อนของผังเมืองและเขตได้แม่นยำที่สุด
⚡️ 2. Secondary High-Speed Engine
Ultra FastLightGBM Regressor (จิตติมา)
- หน้าที่ในระบบ: รองรับการค้นหาพื้นที่กว้าง (Spatial Area Search) และการสร้าง Heatmap ระดับหลายหมื่นแปลง
- ความเร็วการประมวลผล: เร็วกว่าโมเดลอื่น 5–10 เท่า (Inference ในระดับ Milliseconds)
- จุดเด่น: ใช้หน่วยความจำต่ำมาก เหมาะสำหรับการประมวลผลพร้อมกันจำนวนมากบนเว็บเซิร์ฟเวอร์
🚀 สถาปัตยกรรมระบบจริงบน Web Application (Phase 5 Transition)
แผนการนำโมเดล Pipeline (.joblib) ไปต่อยอดสู่แพลตฟอร์มใช้งานจริง
Interactive Leaflet UI
• วาดโพลีกอนแปลงที่ดิน
• คำนวณพิกัด UTM E, UTM N
• คำนวณระยะห่างถนน/BTS อัตโนมัติ
FastAPI + Spatial Index
• ดึงสัดส่วน FAR / OSR ตามกฎหมาย
• จัดหมวดหมู่ Urban Tier อัตโนมัติ
• แปลงข้อมูลเข้า Feature Pipeline
Dual-Engine AVM
• Secondary Engine: LightGBM สำหรับค้นหาเร็ว Real-time
• แปลงกลับด้วย Inverse Log (exp)
Valuation & Tax Output
• ราคารวมทั้งแปลงที่ดิน
• ช่วงความเชื่อมั่น (Price Range)
• คำนวณภาษีที่ดินและสิ่งปลูกสร้าง
🎯 สรุปผลสัมฤทธิ์ Milestone & แผนงานก้าวต่อไป
สรุปความสำเร็จ Phase 4 และเปิดรับคำแนะนำจากคณะกรรมการ (Q&A Session)
✅ ผลสัมฤทธิ์ที่ลุล่วงใน Phase 4 Modeling
- พัฒนาและทดสอบโมเดลครบ 8 โมเดลบน Spatial Block Test Set 43,646 แปลง (0% Leakage)
- บรรลุความแม่นยำ R² = 0.8531 และบีบ MAPE ลงเหลือ 40.89% (ดีขึ้น 4 เท่าตัวจาก Baseline)
- สร้างกรณีศึกษาเชิงวิชาการด้าน Multicollinearity และ Regularization (OLS vs Lasso)
- คัดเลือก Champion ด้วยสถาปัตยกรรม Dual-Engine และ Export Pipeline (.joblib) สำเร็จ
🔨 แผนงานระยะต่อไปสู่ Phase 5 (Final Submission)
- พัฒนา Web Application เต็มรูปแบบ (Leaflet.js + FastAPI + R-tree Spatial Index)
- เพิ่มฟังก์ชันคำนวณประมาณการภาษีที่ดินและสิ่งปลูกสร้างตามประเภทการใช้งานจริง
- ดำเนินการทำ User Testing ทดสอบความเร็วในการตอบสนอง และความง่ายในการใช้งาน
- จัดทำเล่มรายงานและคู่มือสถาปัตยกรรมระบบฉบับสมบูรณ์
ขอขอบพระคุณคณะกรรมการและอาจารย์ที่ปรึกษาทุกท่าน
ทางกลุ่ม @TidinAI พร้อมรับฟังข้อเสนอแนะและตอบข้อซักถามครับ